Servidor de IA local com RTX PRO 6000: como montar, quanto custa e o que dá para rodar além do chat
Matéria narrada pelo Professor
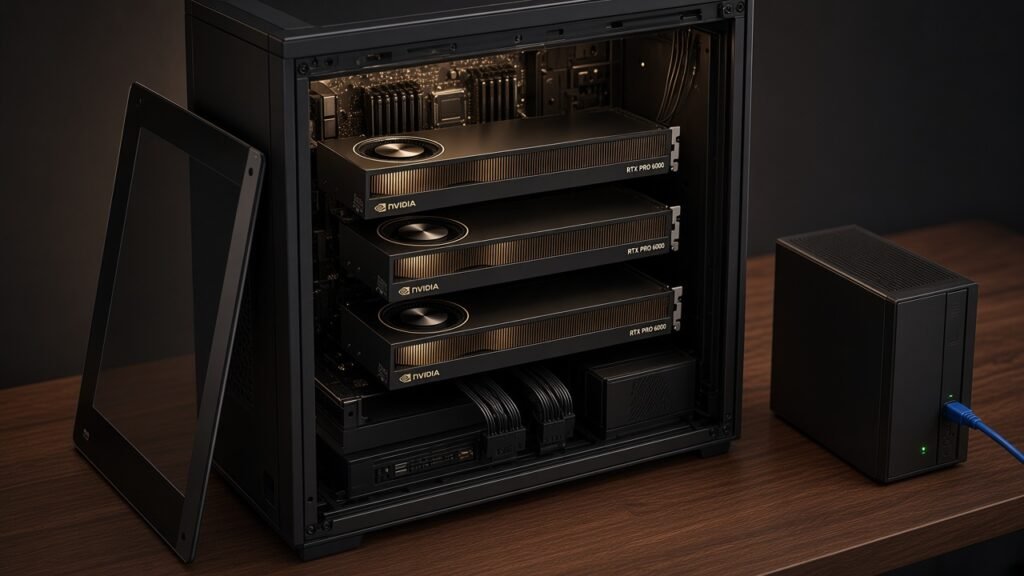
A RTX PRO 6000 Blackwell é a placa de vídeo profissional da NVIDIA com 96 GB de memória própria, três a quatro vezes o que trazem as placas de jogos de topo, de 24 a 32 GB. Com ela, um computador montado em casa ou no escritório roda modelos de inteligência artificial que antes só cabiam em servidores de data center: conversa com modelos de texto grandes, gera imagens e vídeos, cria objetos em 3D, transcreve áudio, lê documentos e ainda pode ser treinado com os próprios dados da empresa. Este guia mostra as versões da placa, as peças, a conta de luz no Brasil, os programas, o que foi medido em cada tipo de trabalho, as licenças e quando comprar compensa mais do que alugar.
A placa em uma ficha
| Item | Workstation | Max-Q | Server |
|---|---|---|---|
| Memória | 96 GB GDDR7 com ECC | 96 GB GDDR7 com ECC | 96 GB GDDR7 com ECC |
| Velocidade da memória | 1.792 GB/s | 1.792 GB/s | 1.597 GB/s |
| Consumo | 600 W | 300 W | até 600 W, configurável |
| Refrigeração | ar entra por baixo e sai por cima | ventoinha única que joga o ar quente para fora, pela traseira | sem ventoinha, depende do ar do servidor |
| Conector de energia | 12V-2×6 de 16 pinos | 16 pinos (PCIe CEM5) | 16 pinos, cabo próprio do servidor |
| Divisão em placas virtuais (MIG) | até 4 | até 4 de 24 GB | até 4 de 24 GB |
Por que 96 GB fazem diferença
Todo modelo de inteligência artificial precisa caber na memória da placa de vídeo para rodar rápido. Essa memória, chamada de VRAM, é separada da memória comum do computador e muito mais veloz. Quando o modelo não cabe, os programas mandam parte dele para a memória comum, e a velocidade despenca.
Os modelos são medidos em bilhões de parâmetros, os números que guardam o que eles aprenderam. Para economizar espaço, existe a quantização: guardar cada número com menos casas decimais, em 8 bits, 4 bits ou menos. A qualidade cai um pouco e o tamanho cai muito. É por isso que um modelo de 120 bilhões de parâmetros, que ocuparia centenas de gigabytes no formato original, roda numa única placa de 96 GB. A arquitetura Blackwell acelera um formato de 4 bits chamado FP4, pensado justamente para isso.
A velocidade de um modelo de texto é medida em tokens por segundo. Token é um pedaço de palavra: quanto mais tokens por segundo, mais rápido o texto aparece na tela.
Qual das três versões
As três têm o mesmo chip e a mesma memória. Muda o jeito de dissipar calor, o consumo e onde elas foram feitas para ficar.
A Workstation gasta até 600 W e é a mais rápida. O ar entra por baixo e sai por cima, de volta para dentro do gabinete. A Puget Systems, montadora americana de estações de trabalho, diz que ela não serve para a maioria das montagens com várias placas, porque uma esquenta a outra.
A Max-Q gasta metade, 300 W, e usa uma ventoinha só, do tipo *blower*, que empurra o ar quente para fora pela traseira do gabinete. Ela foi feita para ficar ao lado de outras iguais. Nos testes da Puget com programas de criação, ficou de 5% a 13% abaixo da Workstation.
A Server não tem ventoinha. Depende do vento forte dos servidores de rack, por isso não serve para um gabinete comum. Ela tem a memória um pouco mais lenta.
As três aceitam o MIG, sigla em inglês para “placa de vídeo em várias instâncias”: a placa se divide em até quatro placas virtuais de 24 GB, isoladas entre si. Isso permite, por exemplo, que quatro pessoas de um escritório usem a mesma placa sem que o trabalho de uma atrapalhe o da outra.
Quanto custa
| Versão | Preço de varejo encontrado em 24/10/2026 | Fonte |
|---|---|---|
| Workstation | R$ 105.882,34 | agregador Escorrega o Preço |
| Max-Q | R$ 113.000,00 | agregador GPUPrix |
| Server | R$ 109.411,75 | agregador Escorrega o Preço |
O preço subiu ao longo de 2026. O valor de lançamento listado em março de 2025 era de US$ 8.565. Em agosto de 2026, a loja da própria NVIDIA nos Estados Unidos marcava US$ 16.000 e estava sem estoque, segundo a imprensa americana. A NVIDIA não explicou as altas. A garantia da PNY, que vende a placa no varejo, é de 3 anos, limitada.
As peças em volta da placa
A placa se liga ao computador por PCIe, a “avenida” de dados da placa-mãe. Cada placa de vídeo usa 16 linhas dessa avenida para render tudo. Aqui está a primeira decisão da montagem.
Com uma placa, um processador de mesa resolve. O Ryzen 9 9950X, por exemplo, tem 24 linhas PCIe 5.0 utilizáveis e aceita até 256 GB de memória. As 16 linhas vão para a placa de vídeo e sobram linhas para os SSDs.
Com duas a quatro placas, entra a plataforma de estação de trabalho. O Threadripper PRO 9995WX tem 128 linhas PCIe 5.0 e oito canais de memória. A recomendação da Puget é não encostar uma placa na outra e deixar um slot livre entre elas.
| Item | Uma placa Workstation | Quatro placas Max-Q |
|---|---|---|
| Processador e placa-mãe | Ryzen 9 9950X ou Threadripper | Threadripper PRO 9000 WX com placa-mãe WRX90 |
| Memória do computador | 128 a 256 GB DDR5 | 512 GB com correção de erros, em 8 canais |
| Fonte | 1.200 a 1.300 W, padrão ATX 3.1, com cabo 12V-2×6 próprio | 1.600 a 1.700 W, ATX 3.1 |
| Gabinete | entrada de ar por baixo e saída por cima | um slot livre entre as placas e muito fluxo de ar |
| Tomada | tomada comum | circuito dedicado, de preferência em 220 V |
| Nobreak | interativo com onda senoidal | interativo senoidal de 2.000 VA ou mais |
*Montagem do Tectônica a partir das medições e fichas citadas (StorageReview, Puget, AMD, ASUS e o relato do fórum Level1Techs); não é uma receita oficial da NVIDIA.*
O conector de energia merece atenção. O 12V-2×6 é a revisão do antigo 12VHPWR, com pinos de detecção mais curtos e contatos mais longos, e os cabos antigos continuam compatíveis. O plugue precisa estar encaixado até o fim.
Energia e conta de luz
O site StorageReview mediu o computador inteiro, com uma placa Workstation e um Threadripper, gerando imagens sem parar: média de 918,5 W, com pico de 1.036 W. Parado, o mesmo computador gastava 152 W.
| Situação | Consumo no mês | Custo no mês |
|---|---|---|
| Uma placa trabalhando 24 horas por dia (918 W) | cerca de 661 kWh | cerca de R$ 555 |
| Uma placa ligada e parada 24 horas por dia (152 W) | cerca de 109 kWh | cerca de R$ 92 |
| Quatro Max-Q trabalhando 24 horas por dia (1,7 kW) | cerca de 1.224 kWh | cerca de R$ 1.030 |
*Cálculo do Tectônica com a tarifa residencial média de R$ 0,84 por kWh, média simples de 100 distribuidoras nos dados abertos da ANEEL em 24/10/2026, sem impostos e sem bandeira tarifária. Impostos e bandeira encarecem a conta; a tarifa varia de R$ 0,41 a R$ 1,57 conforme a distribuidora.*
Com quatro placas, a corrente também pesa. Pela conta do Tectônica, 1,76 kW em 127 V puxam cerca de 13,9 ampères, perto do limite de muitos circuitos de casa. Em 220 V, a corrente cai quase pela metade.
O que um usuário encontrou montando quatro placas
Um usuário do fórum Level1Techs relatou, entre julho e setembro de 2026, a montagem de um computador com quatro Max-Q, um Threadripper PRO 7985WX, 512 GB de memória e fonte de 1.700 W, por cerca de US$ 54 mil. É um relato de uma montagem só, não um teste de laboratório.
| O que aconteceu | Como foi resolvido |
|---|---|
| Consumo de 1.650 a 1.760 W na tomada derrubou um disjuntor de 15 A na rede de 120 V | limitou o processador a 2,2 GHz |
| Placas a 88–91 °C no teste de estresse, a de cima mais quente | mais ventoinhas no gabinete |
| Primeira placa-mãe não ligava | trocou de marca |
| Programa de inferência travava com duas placas | desligou funções de isolamento de hardware (ACS/IOMMU) |
| Nobreak de dupla conversão desarmava o disjuntor | trocou por um interativo senoidal de 2.000 VA |
Os programas para ligar tudo
O sistema mais usado nesse tipo de servidor é o Linux. A NVIDIA avisa que a arquitetura Blackwell só funciona com a versão de código aberto dos módulos do driver. Os principais programas têm versão em contêiner Docker, um pacote que traz o programa já com tudo de que ele depende.
Para texto, três motores cobrem a maioria dos casos. O Ollama roda modelos com poucos comandos. O vLLM e o TensorRT-LLM, da própria NVIDIA, atendem muitas pessoas ao mesmo tempo. Por cima deles, o Open WebUI oferece uma janela de conversa no navegador, parecida com a dos serviços pagos.
Texto: o que cabe e com que velocidade
| Modelo | Formato | Velocidade medida | Fonte |
|---|---|---|---|
| gpt-oss-120b | 8 bits, llama.cpp | 221 tokens/s com contexto curto; 123 com 128 mil tokens | Hardware Corner |
| Qwen3.5 122B | 4 bits, llama.cpp | 98 tokens/s com contexto curto; 66 com 256 mil | Hardware Corner |
| Llama 3.3 70B | 4 bits | 32 tokens/s com contexto curto; 16,6 com 128 mil | Hardware Corner; Database Mart |
| Qwen3 32B | 4 bits | 55 tokens/s | Hardware Corner; Database Mart |
| Llama 3.3 70B, versão Server | FP4, TensorRT-LLM | 1.724 tokens/s por placa somando muitos pedidos simultâneos | NVIDIA |
| Qwen3-235B | FP4, TensorRT-LLM | precisa de quatro placas | NVIDIA |
| DeepSeek-R1 (671 bilhões) | 4 bits | não cabe numa placa: mais de 330 GB, pela conta do Tectônica | Hugging Face |
O número de 1.724 tokens por segundo não é a velocidade de uma conversa. É a soma de dezenas de pedidos atendidos ao mesmo tempo, o que interessa a uma empresa que oferece o modelo para muitos funcionários.
Além do texto
A memória grande pesa ainda mais fora do chat. Em várias áreas não há medição independente feita com esta placa; nesses casos, o que existe é a exigência de memória publicada por quem criou o modelo.
Imagem. O StorageReview mediu 5,36 segundos por imagem no SDXL, empatado com a RTX 5090, placa de jogos de topo. A NVIDIA alega ganho maior, mas contra a geração anterior. O FLUX.2 dev completo, segundo os autores, pede uma placa do porte de uma H100, de data center; com 96 GB, ele roda sem cortes.
Vídeo. É onde a diferença é maior. O Wan 2.2 de 14 bilhões de parâmetros pede 80 GB ou mais, o HunyuanVideo em 720p pede 60 GB e o Mochi cerca de 60 GB, segundo os próprios desenvolvedores. Placas de 24 a 32 GB só rodam esses modelos jogando parte deles para a memória do computador. Não há tempo de geração medido nesta placa.
3D. O Hunyuan3D 2.1 pede 29 GB para gerar forma e textura juntas, e o TRELLIS.2 pede no mínimo 24 GB. Os dois cabem com folga, e sobra espaço para outros modelos ao mesmo tempo. Também aqui não há medição nesta placa.
Áudio e voz. Os modelos são pequenos. O faster-whisper transcreve 13 minutos de áudio em 16 a 17 segundos numa placa de jogos intermediária. A vantagem dos 96 GB está em manter transcrição, voz e um modelo de texto carregados juntos.
Visão. Modelos que leem imagens, fotos e documentos escaneados, com 27 a 38 bilhões de parâmetros, cabem inteiros sem compactação. O leitor de texto em imagem Surya faz 5,35 páginas por segundo numa RTX 5090.
Ajuste fino. É o treino adicional de um modelo pronto com os dados da própria empresa. A técnica QLoRA treina só uma pequena parte do modelo, com ele compactado. Segundo a Unsloth, o QLoRA de um modelo de 70 bilhões pede 41 GB, e o de 120 bilhões pede 65 GB. Um teste publicado no Japão fez o ajuste do gpt-oss-120b numa única Max-Q, com cerca de 9.400 exemplos por hora, perto dos 9.200 de uma H100. Em outro modelo, o Qwen3-32B, a H100 foi cerca de 2,5 vezes mais rápida.
Busca nos próprios documentos. A técnica chamada RAG faz o modelo responder com base em contratos, manuais ou prontuários guardados na empresa. O modelo que indexa os textos é pequeno; o ganho é rodar indexador, reordenador e um modelo de texto grande na mesma placa, sem que nada saia do prédio.
Render e edição de vídeo. A Puget mediu, no Blender, de 5% a 10% acima da RTX 5090 e, no DaVinci Resolve, de 21% a 78% acima da RTX 6000 Ada, a geração anterior. O ganho real aparece em cenas enormes e com vários programas abertos: num teste, 49 GB estavam ocupados.
| Área | O que os 96 GB permitem | Medição nesta placa |
|---|---|---|
| Imagem | modelos completos do porte do FLUX.2 dev | SDXL, 5,36 s por imagem |
| Vídeo | Wan 2.2 14B, HunyuanVideo e Mochi sem descarregar na memória comum | não há |
| 3D | Hunyuan3D e TRELLIS com folga | não há |
| Áudio e voz | vários modelos carregados ao mesmo tempo | não há |
| Visão | modelos de 27 a 38 bilhões sem compactar | não há |
| Ajuste fino | QLoRA de modelos de até 120 bilhões | gpt-oss-120b numa Max-Q |
| Busca em documentos | indexador, reordenador e modelo grande juntos | não há |
| Render e edição | cenas grandes e vários programas abertos | Blender e DaVinci Resolve |
As licenças dos modelos
Modelo aberto não quer dizer livre para qualquer uso. Quem vai usar no trabalho precisa conferir a licença.
| Modelo | Licença | Uso comercial |
|---|---|---|
| gpt-oss-120b | Apache 2.0 | sim |
| Família Qwen3 | Apache 2.0 | sim |
| Llama 3.3 70B | Llama 3.3 Community License | sim, até 700 milhões de usuários por mês, com o aviso "Built with Llama" |
| DeepSeek-R1 | MIT | sim |
| FLUX.1 dev e FLUX.2 dev | FLUX Non-Commercial | não |
| Stable Diffusion 3.5 e Stable Audio Open | Stability Community License | sim, abaixo de US$ 1 milhão de receita por ano |
| Wan 2.x, Mochi, Qwen-Image, Kokoro, ACE-Step | Apache 2.0 | sim |
| HunyuanVideo e Hunyuan3D | Tencent Community | sim, exceto na União Europeia, no Reino Unido e na Coreia do Sul |
| LTX-2 | licença própria de pesos abertos | sim, abaixo de US$ 10 milhões de receita por ano |
| XTTS-v2 | Coqui Public Model License | não |
| F5-TTS | CC-BY-NC-4.0 | não |
| Whisper | MIT | sim |
Segurança e lei
Por padrão, o Ollama só aceita conexões do próprio computador. Basta uma configuração para abri-lo à rede, e a documentação não menciona senha. O Open WebUI transforma em administrador a primeira conta criada. A orientação da equipe do Open WebUI é não expor essas portas na internet: o acesso de fora deve passar por uma VPN, como WireGuard ou Tailscale, ou por um proxy com HTTPS e senha.
Rodar em casa mantém os dados dentro de casa, mas não dispensa a LGPD: quem guarda dados de clientes continua responsável pela segurança deles. A voz merece cuidado especial. Quando serve para identificar alguém, ela entra na categoria de dado biométrico, que a LGPD trata como dado sensível. A Lei 15.123, de 2025, aumentou a pena da violência psicológica contra a mulher quando a voz ou a imagem é alterada por inteligência artificial, e o TSE proíbe *deepfake* na propaganda eleitoral. O projeto do marco legal da inteligência artificial, o PL 2338/2023, ainda tramita na Câmara e não é lei. Quem pensa em clonar a voz de outra pessoa precisa de autorização dela e de orientação jurídica.
Comprar ou alugar
| Opção | Custo |
|---|---|
| RunPod, RTX PRO 6000, Community | US$ 1,69 por hora |
| RunPod, RTX PRO 6000, Secure | US$ 2,49 por hora |
| Placa comprada nos EUA (loja da NVIDIA, agosto/2026) | US$ 16.000 |
| Ponto de equilíbrio, só a placa | cerca de 6.400 horas a US$ 2,49, ou 9 meses ligada direto |
*Ponto de equilíbrio calculado pelo Tectônica, sem energia, sem o resto do computador e sem impostos.*
Quem traz a placa de fora paga imposto de importação de 60%, com desconto de US$ 30 em site certificado, mais ICMS de 17% a 20% calculado sobre o próprio valor com o imposto, segundo a Receita Federal.
Onde as fontes divergem
| Ponto | Divergência |
|---|---|
| Preço no Brasil | a Max-Q aparece mais cara que a Workstation, ao contrário do que acontece nos EUA |
| Geração de imagem | a NVIDIA alega 2,5 vezes mais rapidez contra a geração anterior; o teste independente mostra empate com a RTX 5090 |
Para quem compensa
O servidor com RTX PRO 6000 faz sentido para quem trabalha todos os dias com modelos grandes e não pode, ou não quer, mandar dados para fora: escritórios que lidam com documentos sigilosos, estúdios que geram vídeo e 3D, equipes que querem treinar um modelo com o próprio acervo e pesquisadores que precisam testar muitos modelos seguidos. Para esse uso contínuo, a conta de ponto de equilíbrio pende para a compra em menos de um ano. Para quem usa poucas horas por mês, o aluguel por hora sai mais barato e dispensa a montagem. Com uma placa Max-Q ou Workstation, um processador com linhas PCIe suficientes, fonte nova com o conector certo, bom fluxo de ar, tomada adequada e as portas fechadas para a internet, dá para ter em casa um computador que roda texto, imagem, vídeo, voz e 3D com a mesma máquina.
Fontes: 1 · 2 · 3 · 4 · 5 · 6 · 7 · 8 · 9 · 10 · 11 · 12 · 13 · 14 · 15 · 16 · 17 · 18 · 19 · 20 · 21 · 22 · 23 · 24 · 25 · 26 · 27 · 28 · 29 · 30 · 31 · 32 · 33 · 34 · 35 · 36 · 37 · 38 · 39 · 40 · 41 · 42 · 43 · 44 · 45 · 46 · 47 · 48 · 49 · 50 · 51 · 52 · 53 · 54 · 55 · 56 · 57 · 58 · 59 · 60 · 61 · 62 · 63 · 64 · 65 · 66
Assine a newsletter gratuitamente para receber um resumo semanal e matérias do seu interesse.
Sem trava e sem cadeado: tudo no Tectônica é aberto. A newsletter não destranca nada — ela poupa a sua volta ao site.