A raspagem dos sebos: por que a IA foi buscar papel quando o digital acabou
Matéria narrada pelo Professor
Um livreiro holandês recebeu um pedido de 3.001 exemplares e achou que era golpe. Um sebo inglês que vendia dois mil livros por semana recebeu esse volume num único dia. Os livros vão para galpões onde máquinas hidráulicas cortam a lombada, as folhas passam por escâneres de alta velocidade e o que sobra é descartado. Este aprofundamento explica por que a indústria de IA foi parar no papel, o que a justiça americana decidiu e o que não decidiu, onde a internet clandestina realmente entra nessa história — e por que a mesma operação que um juiz americano liberou seria ilícita no Brasil.
A cena, antes da explicação
Comece pelo concreto, porque o concreto aqui é estranho o bastante.
Pieter de Vries, livreiro antiquário de Haarlem, na Holanda, recebeu o pedido de 3.001 títulos, a maioria publicada entre 2020 e 2021, com destino à China. A mensagem vinha de uma representante de uma empresa chamada 2077AI. Ele resumiu a reação numa frase: *”Fiquei chocado. Muito incomum. Foi por isso que tratei o pedido como spam ou phishing.”* Outros livreiros holandeses receberam o mesmo pedido e chegaram à mesma conclusão — golpe.
Não era golpe.
A Barter Books, sebo em Northumberland, na Inglaterra, vende normalmente entre dois e três mil livros por semana. Recebeu de uma empresa canadense um pedido equivalente a esse volume em um único dia.
Um livreiro profissional que falou anonimamente à 404 Media relatou que as vendas semanais quintuplicaram a partir de abril de 2026: de cerca de vinte livros numa boa semana para várias centenas.
Os pedidos que circulam vão de mil a um milhão de exemplares numa única transação. E uma investigação da 404 Media apurou que grandes lotes têm um destino específico: uma instalação da Amazon em Las Vegas, onde passam por digitalização destrutiva.
O que é “digitalização destrutiva”
O nome é literal.
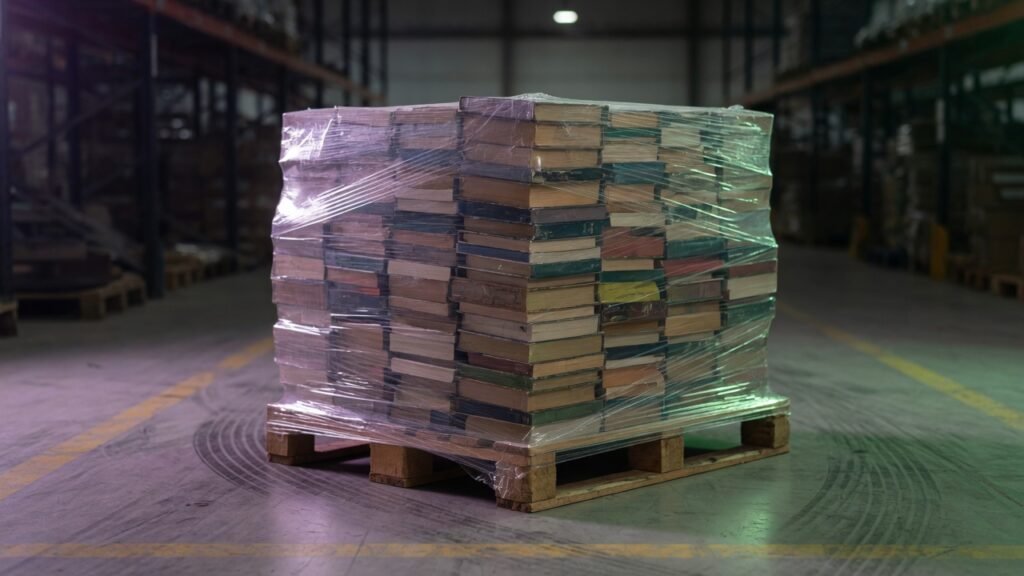
A lombada é cortada fora — em escala industrial, com guilhotinas hidráulicas. O livro deixa de ser um livro e vira uma pilha de folhas soltas. As folhas passam por escâneres de alimentação automática, rápidos justamente porque não precisam preservar nada. O que sobra é descartado.
O caso mais documentado tem nome interno: “Project Panama”, da Anthropic. Documentos do processo mostram a empresa comprando milhões de livros físicos, removendo as encadernações, digitalizando e jogando fora os originais, para montar uma biblioteca digital pesquisável usada no treinamento dos modelos.
Vale dizer o que essa escolha significa em termos práticos: a digitalização destrutiva é mais barata e mais rápida que a não destrutiva. Escanear um livro preservando a encadernação exige equipamento em forma de berço, operador virando páginas, tempo. Cortar a lombada elimina tudo isso. A destruição não é efeito colateral — é o método.
Por que livro velho virou matéria-prima
Aqui está a parte contraintuitiva, e ela tem duas metades.
A primeira metade: o livro impresso tem qualidade que a web não tem. Foi escrito por uma pessoa, passou por edição, revisão e, muitas vezes, revisão por pares. A empresa ISBNdb, que oferece serviço de aquisição em massa para laboratórios de IA, vende exatamente isso: *”conhecimento humano curado, revisado por pares e específico de domínio”*.
A segunda metade é mais interessante: o livro antigo é limpo. Livros publicados antes do lançamento do ChatGPT, em novembro de 2022, têm uma propriedade que nenhum texto novo da internet tem — a garantia de não conter texto gerado por máquina.
Isso importa por um motivo técnico. Modelos treinados repetidamente sobre a própria saída degradam: os erros se acumulam, a variedade encolhe, o resultado empobrece a cada geração. Como a web pós-2022 está contaminada por texto sintético em proporção desconhecida e crescente, a data de publicação virou um selo de procedência.
Daí a expressão que circula no setor: esses livros são procurados por serem “livres de lodo de IA”.
A parede de dados
E agora a pergunta que explica tudo: por que a indústria precisou ir buscar papel?
Porque o texto digital de qualidade está acabando.
A Epoch AI, instituto que estuda tendências de computação em aprendizado de máquina, estima o estoque efetivo de texto público de qualidade gerado por humanos em torno de 300 trilhões de tokens. A projeção do instituto, com intervalo de confiança de 80%, é que esse estoque seja integralmente consumido entre 2026 e 2032.
A estimativa já foi revista mais de uma vez — uma projeção de 2022 apontava 2024, e o limite inferior atual foi empurrado para 2028. A revisão para frente não muda a natureza do problema, só a data: o estoque é finito e está sendo consumido a uma velocidade que cresce.
E há um acelerador pouco comentado: o sobretreinamento. Alimentar um modelo com muito mais dados do que o equilíbrio ideal exigiria deixa o modelo final mais barato de operar depois. Como isso compensa economicamente, a indústria faz — e quanto mais sobretreina, mais cedo o estoque acaba.
A conclusão aritmética é simples: quando o poço digital seca, sobra o que nunca foi digitalizado. E o que nunca foi digitalizado, em escala, são livros.
O que a justiça decidiu, e o que ela não decidiu
Esta é a parte que a cobertura costuma embaralhar, e a distinção é o centro do assunto.
Em junho de 2025, no caso Bartz contra Anthropic, o juiz federal William Alsup, do Norte da Califórnia, decidiu que digitalizar livros impressos comprados legalmente e usar as cópias digitais para treinar modelos de linguagem é uso justo — o *fair use* americano.
Ou seja: comprar o livro e destruí-lo para treinar a máquina foi considerado lícito nos Estados Unidos.
O que não foi considerado lícito: baixar os mesmos livros de bibliotecas piratas. As alegações referentes ao download de obras da LibGen e da PiLiMi seguiram por outro caminho.
O desfecho: a Anthropic fechou acordo de US$ 1,5 bilhão, sem admitir responsabilidade, com previsão de cerca de US$ 3 mil por título atingido.
A leitura correta dessa combinação é desconfortável e precisa ser dita: o recado que a decisão e o acordo mandam ao mercado é que comprar e destruir sai mais barato que piratear. A compra em massa de livros usados é, em parte, consequência direta disso — é o caminho que o tribunal apontou como seguro.
As bibliotecas clandestinas
A parte pirata da história não é boato, e tem processo com documento.
Registros internos revelados em litígio mostram a Meta baixando material em massa via Anna’s Archive, usando protocolos de compartilhamento ponto a ponto — o que, segundo os autores das ações, significa que a empresa não só baixou como redistribuiu as obras para outros usuários da rede enquanto baixava. A Anthropic teve suas práticas apontadas por um juiz federal. O uso pela OpenAI é objeto de litígio em curso.
Uma precisão que importa: LibGen, Anna’s Archive, PiLiMi e Bibliotik são bibliotecas-sombra de internet aberta — acessíveis por navegador comum, sem Tor, sem rede clandestina. São ilegais, não são ocultas. A confusão entre “pirata” e “deep web” é comum e vale desfazer, porque a internet clandestina de verdade entra nesta história por outra porta — e por duas.
Onde a internet clandestina realmente entra
Primeira porta: o que já está dentro dos dados.
Pesquisadores da Truffle Security examinaram 400 terabytes de dados do arquivo Common Crawl — 2,67 bilhões de páginas — e encontraram 11.908 credenciais que ainda autenticavam: chaves de API, senhas e tokens que desenvolvedores deixaram gravados em código e páginas públicas. Havia chaves da Amazon Web Services e do MailChimp, entre 219 tipos distintos.
O Common Crawl é usado, ao menos em parte, no treinamento de modelos da OpenAI, DeepSeek, Google, Meta, Anthropic e Stability.
Leia com atenção o que isso significa: material vazado, credenciais vivas e segredos que deveriam estar em cofre foram varridos junto com o resto da web e entraram nos dados de treinamento — não por decisão de alguém, mas porque a raspagem não distingue. A fronteira entre “web pública” e “material que não deveria estar público” não é respeitada pelo raspador, porque ela não existe do ponto de vista técnico.
Segunda porta, e ela inverte os papéis: os próprios dados de treinamento viram mercadoria clandestina. Num ataque de cadeia de suprimentos em 2026, 4 terabytes de material da empresa Mercor — vídeos de entrevistas, digitalizações de passaporte, números de seguro social e metodologias proprietárias de treinamento, de mais de 40 mil prestadores — foram roubados e leiloados na dark web.
Ou seja: a indústria que raspa a internet também é raspada, e o produto do roubo é vendido exatamente no lugar que o senso comum imagina como origem dos dados.
A categoria correta de cada afirmação: que empresas usaram bibliotecas piratas é fato documentado em processo. Que material vazado entrou nos dados via Common Crawl é achado de pesquisa publicada. O que não há é documentação de empresa de IA indo deliberadamente à rede Tor colher dados para treinamento — o que existe, e é grave o bastante, é a contaminação por varredura indiscriminada e o roubo na direção oposta.
O Brasil nesta história
Duas frentes, e a segunda é a que ninguém está olhando.
A primeira: os sebos brasileiros já sentem. A onda de compra em massa chegou ao mercado nacional, com os mesmos personagens — plataformas que intermedeiam e preservam o anonimato do comprador final. O setor de livros usados no Brasil se organiza em torno da Estante Virtual, no ar desde 2005, que reúne sebos de todo o país num catálogo só. É uma vitrine nacional unificada — e, para quem quer comprar cem mil exemplares sem visitar cem mil lojas, é exatamente a porta de entrada.
Para o sebo, no curto prazo, é dinheiro que não existia. Uma loja que vendia vinte livros por semana e passa a vender centenas não vai perguntar muito.
A segunda frente é jurídica, e a diferença é enorme.
**O Brasil não tem *fair use*. A Lei 9.610/98 não traz uma cláusula geral de uso justo: traz uma lista fechada de limitações, no artigo 46. E o que essa lista permite, quanto a cópia, é a reprodução de “pequenos trechos”, em um só exemplar, para uso privado do copista**, sem intuito de lucro.
Nenhuma dessas três condições cabe no que se descreveu acima. Digitalizar a obra inteira não é pequeno trecho. Fazer isso para treinar um produto comercial não é uso privado nem sem lucro.
A conclusão jurídica, dita com o cuidado devido: comprar um livro no Brasil dá a você o exemplar, não o direito de reproduzi-lo. A operação que o juiz Alsup considerou uso justo nos Estados Unidos — comprar, cortar, digitalizar e treinar — não encontra amparo na lista do artigo 46. Isso é leitura da lei, não decisão judicial: não há, até aqui, caso brasileiro julgado sobre treinamento de IA com obra protegida, e o marco legal da IA, o PL 2338, segue na Câmara sem sanção.
Some as duas frentes e o retrato fica claro: o Brasil está vendendo o insumo para uma operação que, feita aqui, seria provavelmente ilícita — e sem lei em vigor que discipline o que acontece do outro lado.
O que se perde quando o livro é destruído
Vale registrar, porque é o custo que não aparece em nenhuma planilha.
Edição esgotada não volta. Muito do que está em sebo não tem reimpressão prevista e não existe em digital. Quando o exemplar é cortado, a tiragem daquela edição diminui em um — e, em compras de centenas de milhares, diminui de verdade.
O livro usado carrega mais que o texto. Dedicatória, anotação de margem, carimbo de biblioteca extinta, correção manuscrita de quem leu antes. Nada disso sobrevive ao escâner, e nada disso está no texto que o modelo aprende.
E há uma assimetria de destino: o texto vira peso num modelo que ninguém pode abrir para conferir, e o objeto que o continha vira papel picado. A digitalização preservadora existe, custa mais e produz um arquivo que continuaria acessível a pessoas. A escolha pela destrutiva é uma escolha de custo.
O que não se sabe
– Não se sabe a escala total. Os volumes vêm de relatos de livreiros e de reportagem, não de divulgação das compradoras — que operam por intermediários justamente para não aparecer.
– Não se sabe quem compra o quê. Os intermediários vendem anonimato como parte do serviço.
– Não há número público de quantos títulos esgotados foram destruídos, nem levantamento de quantos deles não tinham versão digital.
– Não se sabe o efeito real no resultado dos modelos. A premissa de que livro pré-2022 melhora o treinamento é plausível e é o que move o mercado, mas não há estudo público comparando modelos treinados com e sem esse acervo.
– Não se sabe o tamanho da contaminação da web por texto sintético, que é a premissa por trás de tudo isso.
O fecho
A indústria de IA passou três anos dizendo que os dados eram um recurso praticamente infinito. O que os sebos revelam é o contrário: os dados eram um estoque, o estoque tem fundo, e o fundo está à vista.
Quando um insumo escasseia, o mercado vai buscá-lo onde ele ainda está barato e desprotegido. Livro usado é as duas coisas. Um exemplar de sebo custa alguns reais, não tem dono organizado para reclamar, e o autor que o escreveu já foi pago — uma vez, há vinte anos, pela edição original.
O detalhe mais revelador desta história é o veredicto americano: comprar e destruir é uso justo, baixar de graça é violação. A diferença entre as duas coisas, do ponto de vista do autor cujo texto vai para dentro do modelo, é nenhuma. Mas é essa diferença que está organizando um mercado mundial de compra de papel para trituração.
E para o Brasil sobra a posição de sempre: fornecedor de matéria-prima barata, sem lei em vigor sobre o que é feito dela, vendendo por alguns reais o exemplar que alimentará um produto que depois voltará para cá cobrado em dólar.
Fontes: 1 · 2 · 3 · 4 · 5 · 6 · 7 · 8 · 9 · 10 · 11 · 12 · 13 · 14 · 15 · 16 · 17 · 18 · 19 · 20
Assine a newsletter gratuitamente para receber um resumo semanal e matérias do seu interesse.
Sem trava e sem cadeado: tudo no Tectônica é aberto. A newsletter não destranca nada — ela poupa a sua volta ao site.